

在前面的實作中,我們假設一切都會順利運作:網頁一定抓得到、YouTube 一定有字幕、API 永遠不會斷線。但在真實世界的自動化場景中,意外是常態。
當我們將系統上線後,可能會遇到以下狀況:
如果沒有處理這些狀況,整個 Workflow 會直接在半路 Crash。不僅後續的 Notion 寫入會停擺,使用者在 Telegram 那端也會無止盡地乾等。
在設計 AI 自動化系統時,我們必須主動導入 Error Handling。主要分為兩個層次:
錯誤處理機制會包覆在每一個依賴外部服務(如 HTTP Request 呼叫 FastAPI 或 Gemini API)的節點周圍。在 n8n 中,我們可以透過節點的進階設定來達成。
Step 1:設定 Retry 機制
找到流程中最容易因為網路問題失敗的節點(例如呼叫 Gemini 的節點)。
Step 2:設定 Error Path (開啟 Continue On Fail)
對於「確實可能找不到資料」的節點(例如 YouTube 字幕抓取),我們必須建立錯誤分支。
在該節點的 Settings 分頁中,開啟 Continue On Fail。
這代表即使這個節點發生錯誤,Workflow 也不會中斷,而是會帶著「錯誤資訊」繼續往下走。
Step 3:分流與發送失敗通知
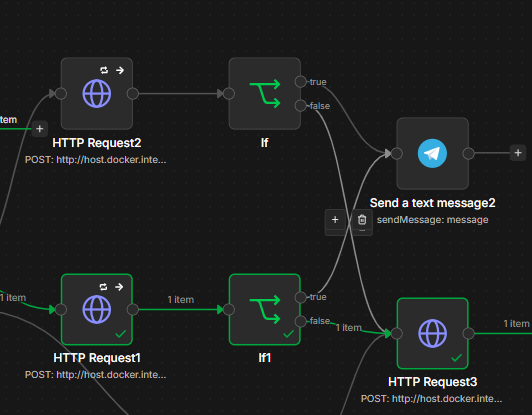
像上圖這樣,就可以在telegram接收到失敗通知,進而檢查自己給的連結。
現在系統具備自我修復與優雅降級的能力。遇到暫時性問題會積極重試;遇到無法解決的錯誤時,能明確攔截並發送友善的失敗通知。系統穩定度與使用者體驗大幅躍升。


 iThome鐵人賽
 看影片追技術